描述
內容簡介
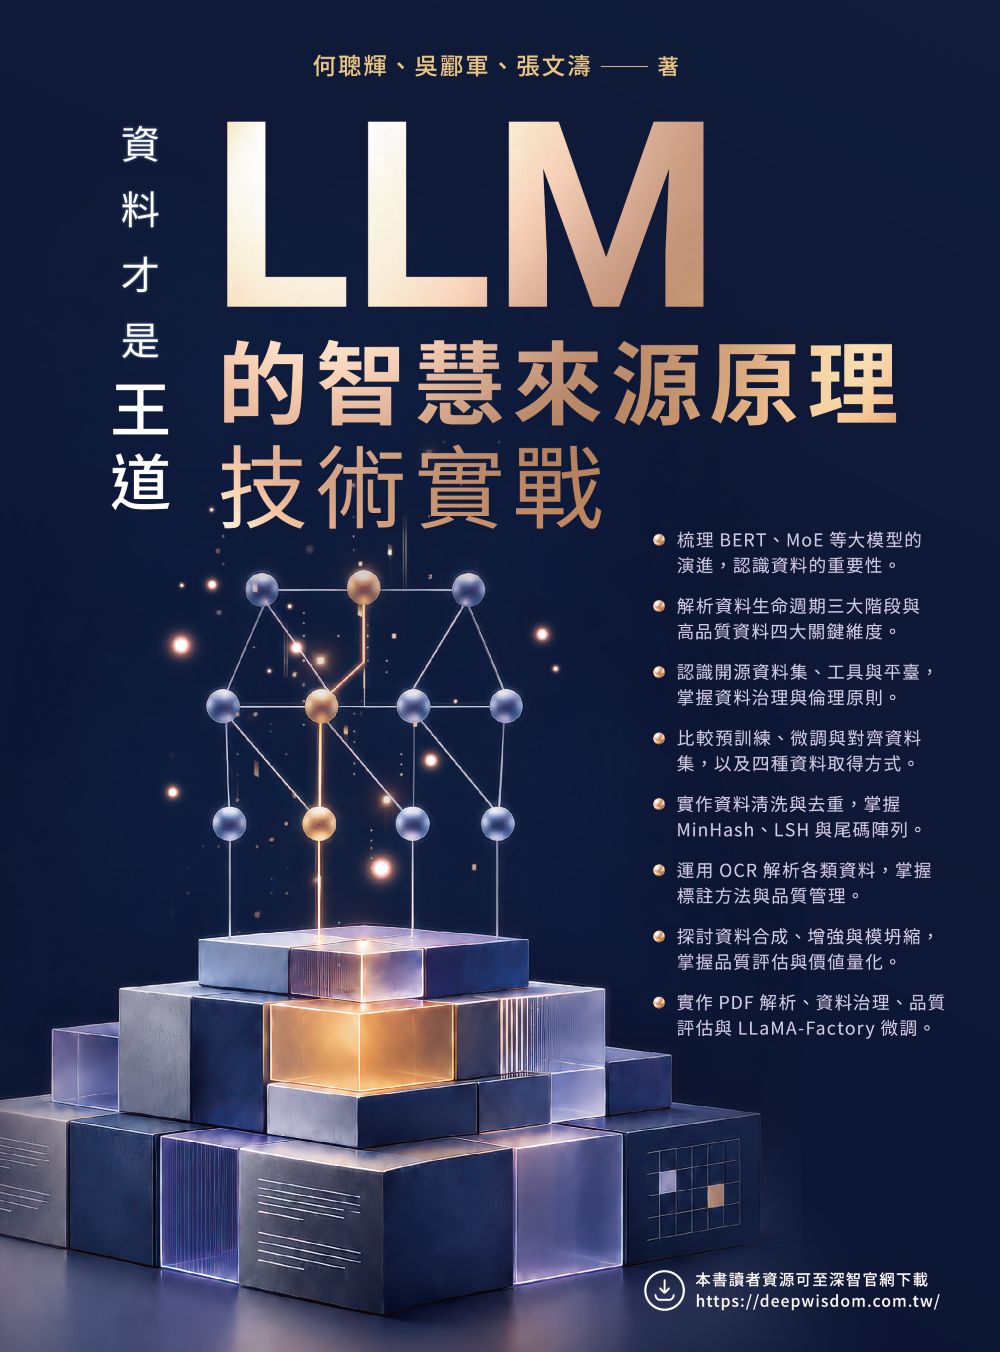
| ★梳理 BERT、MoE 等大模型的演進,認識資料的重要性
★解析資料生命週期三大階段與高品質資料四大關鍵維度 ★認識開源資料集、工具與平臺,掌握資料治理與倫理原則 ★比較預訓練、微調與對齊資料集,以及四種資料取得方式 ★實作資料清洗與去重,掌握 MinHash、LSH 與尾碼陣列 ★運用 OCR 解析各類資料,掌握標註方法與品質管理 ★探討資料合成、增強與模型坍縮,掌握品質評估與價值量化 ★實作 PDF 解析、資料治理、品質評估與 LLaMA-Factory 微調
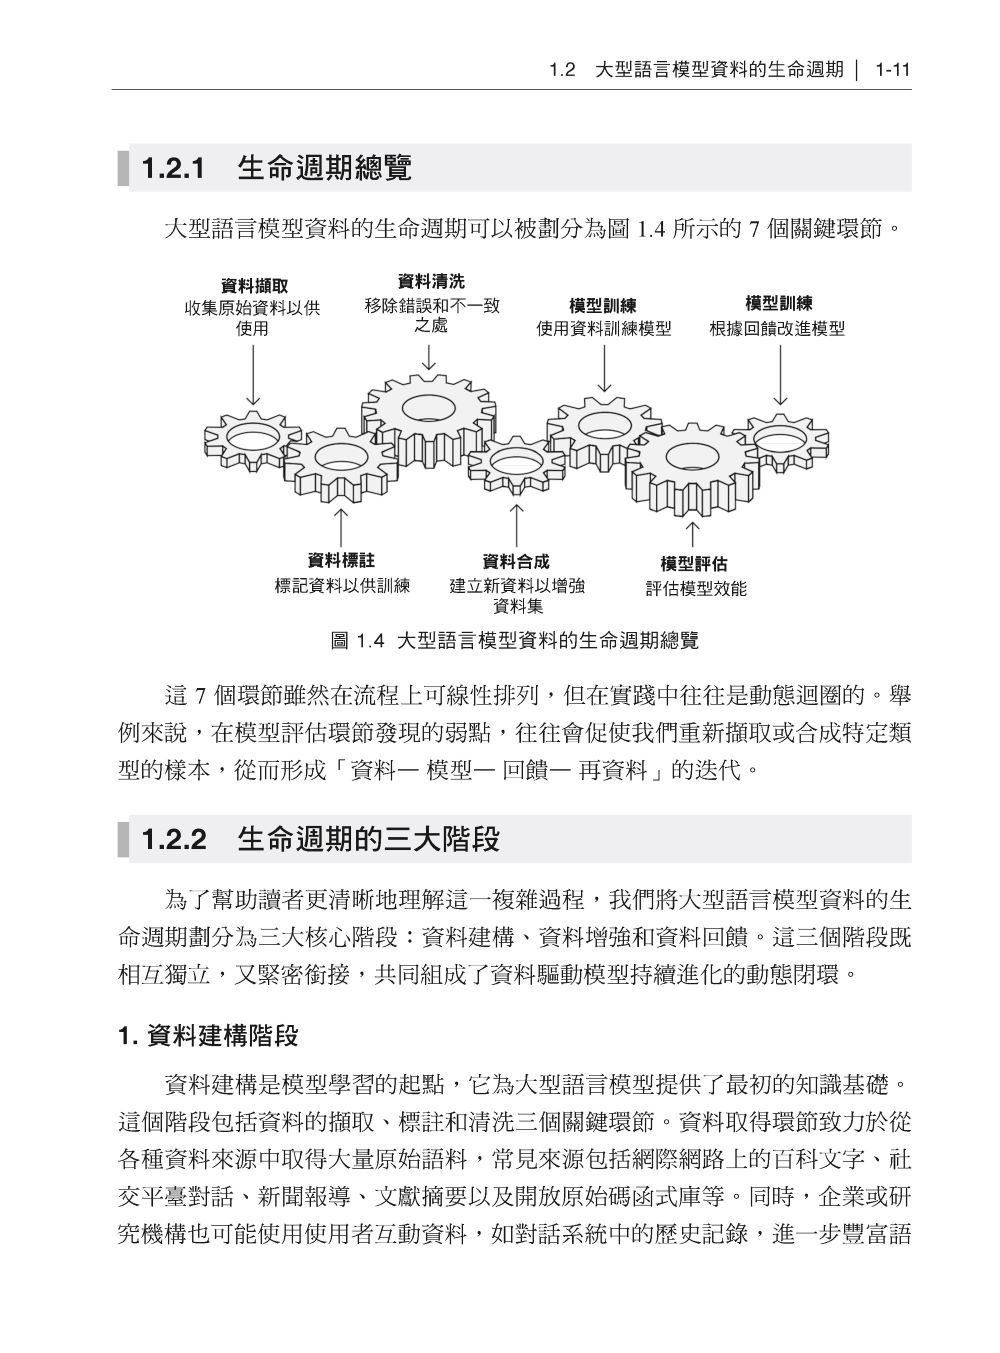
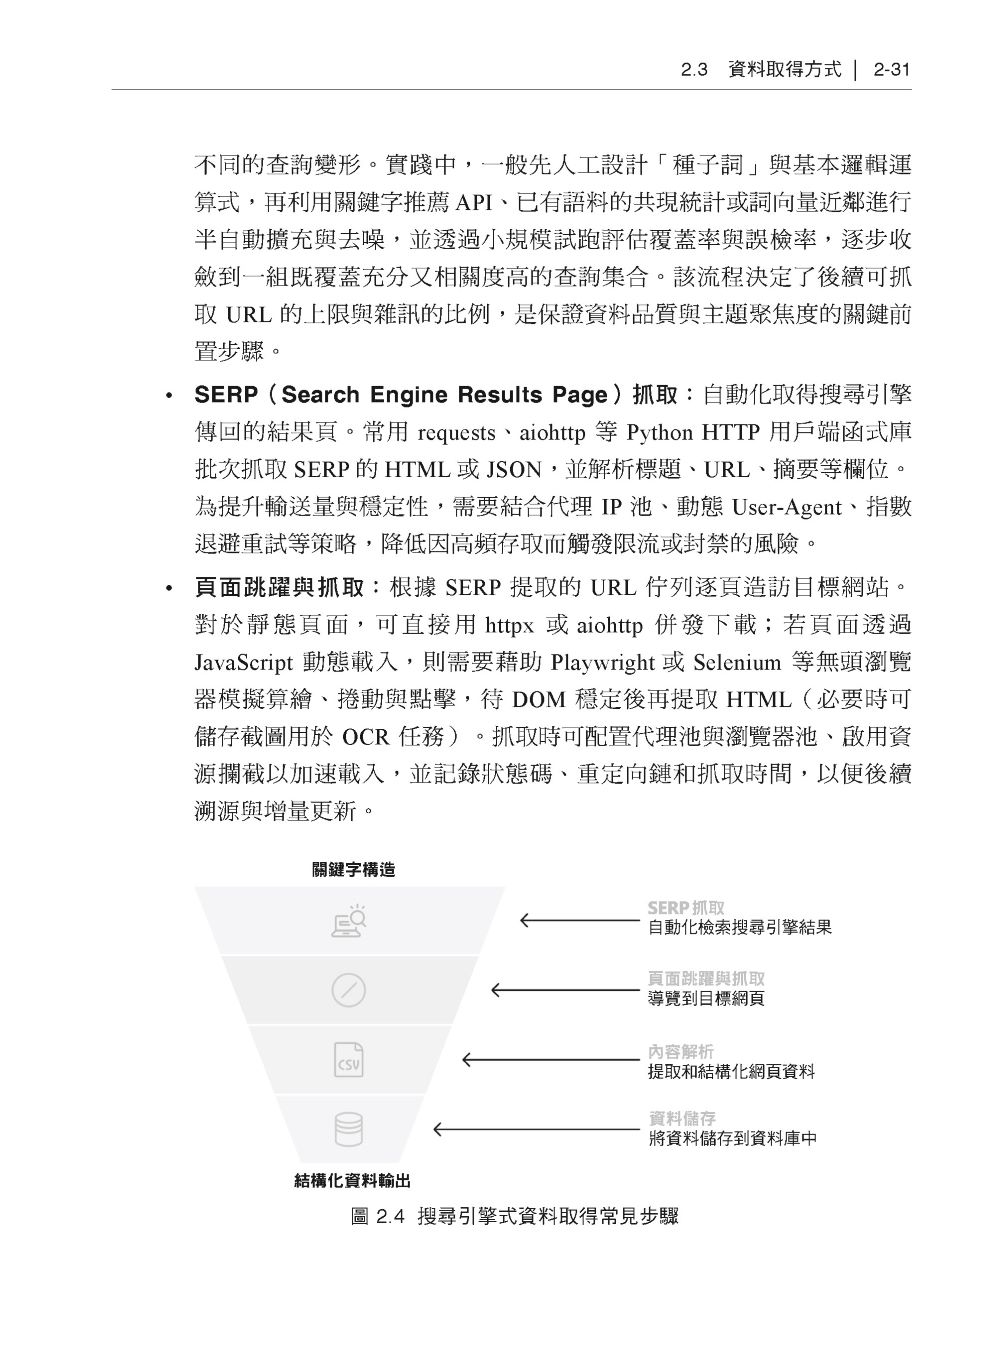
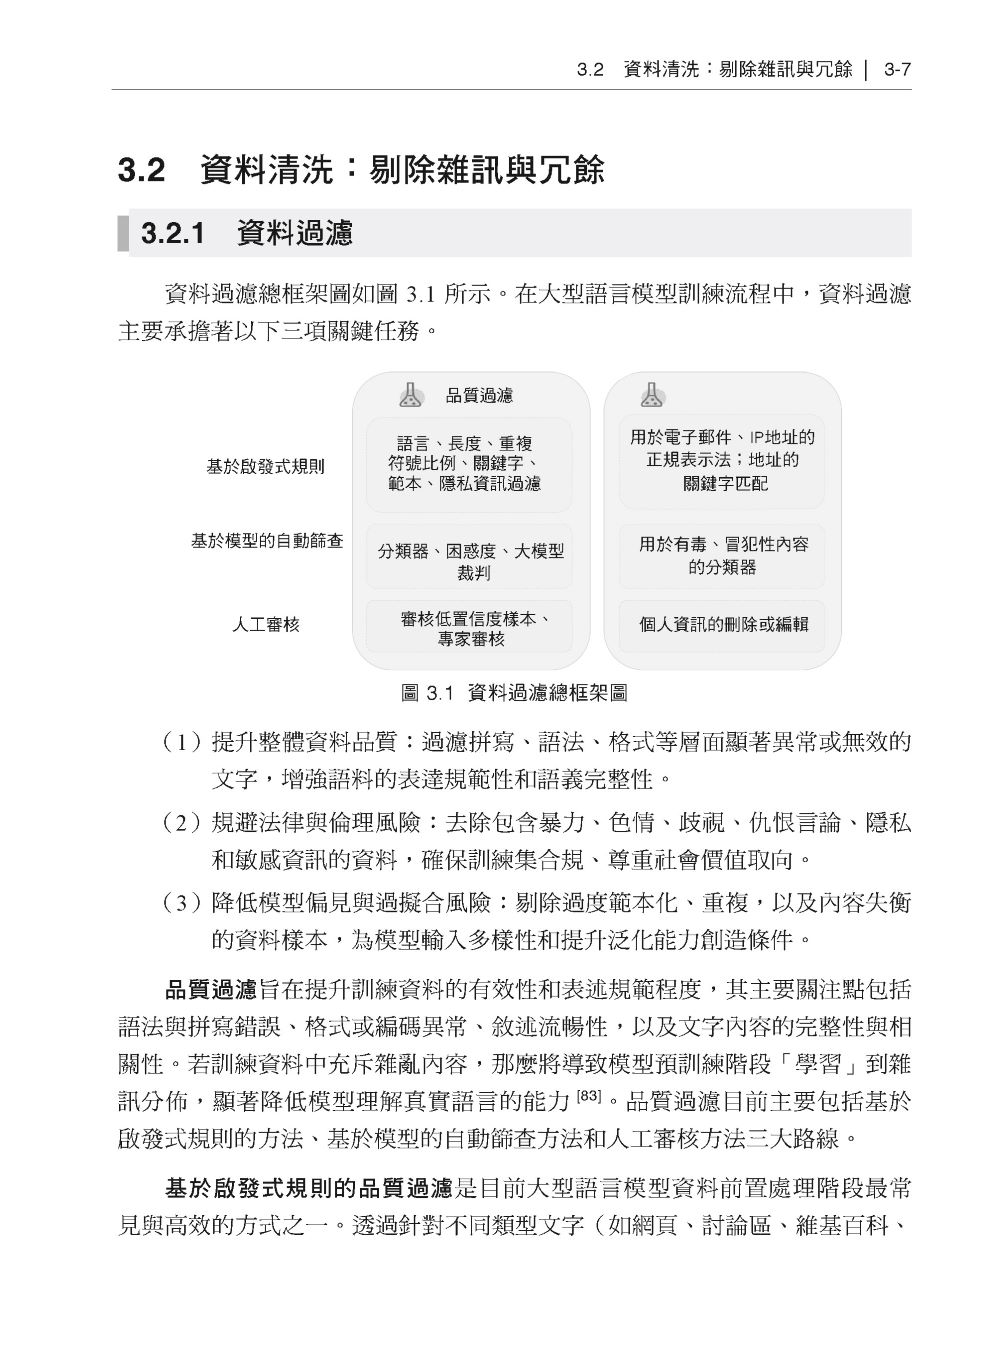
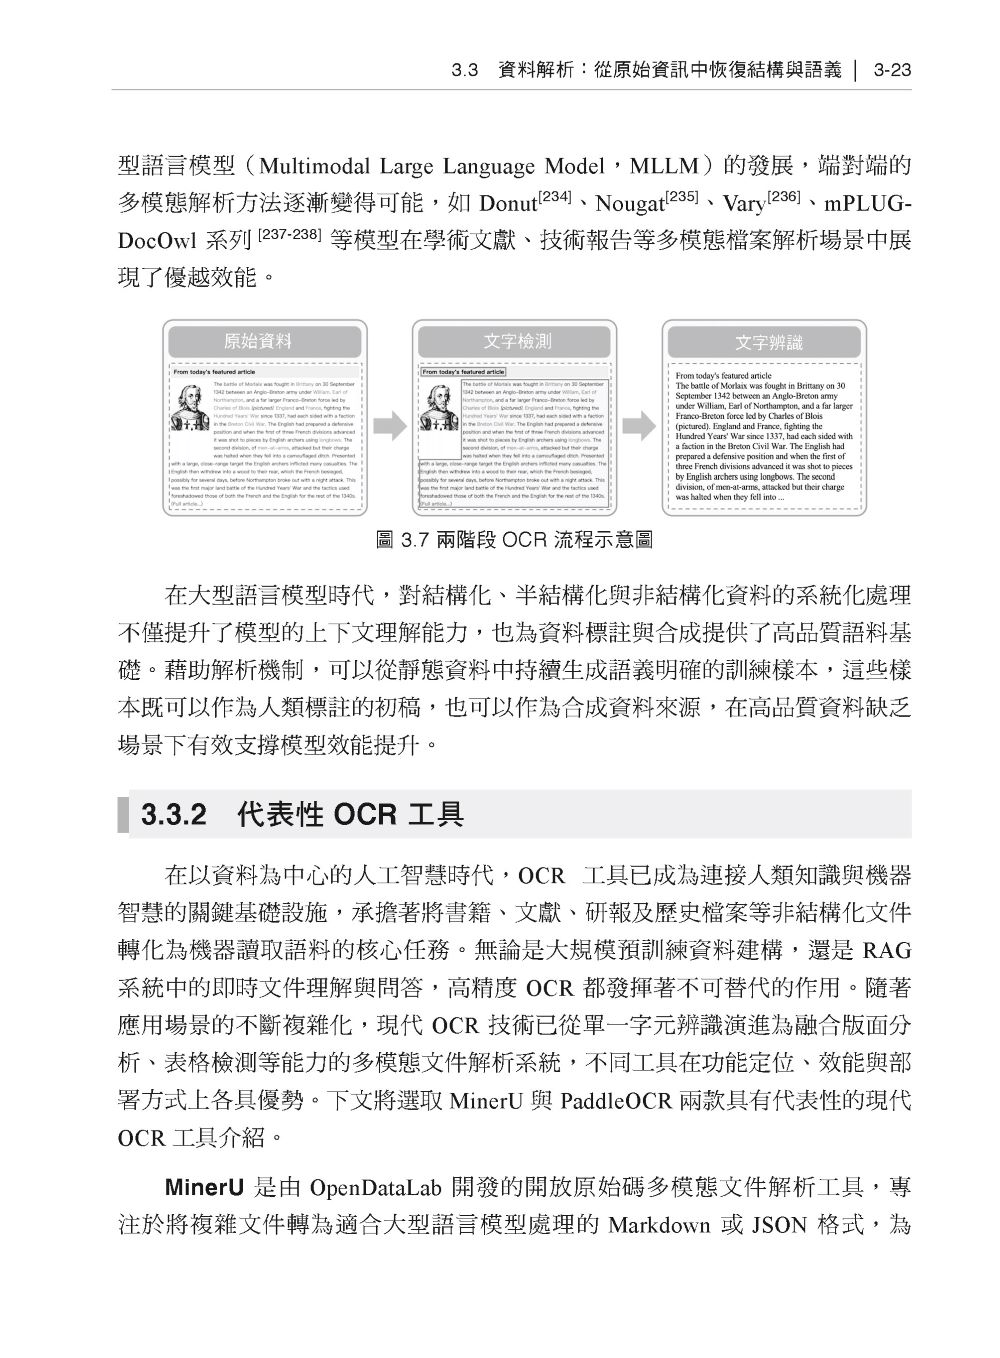
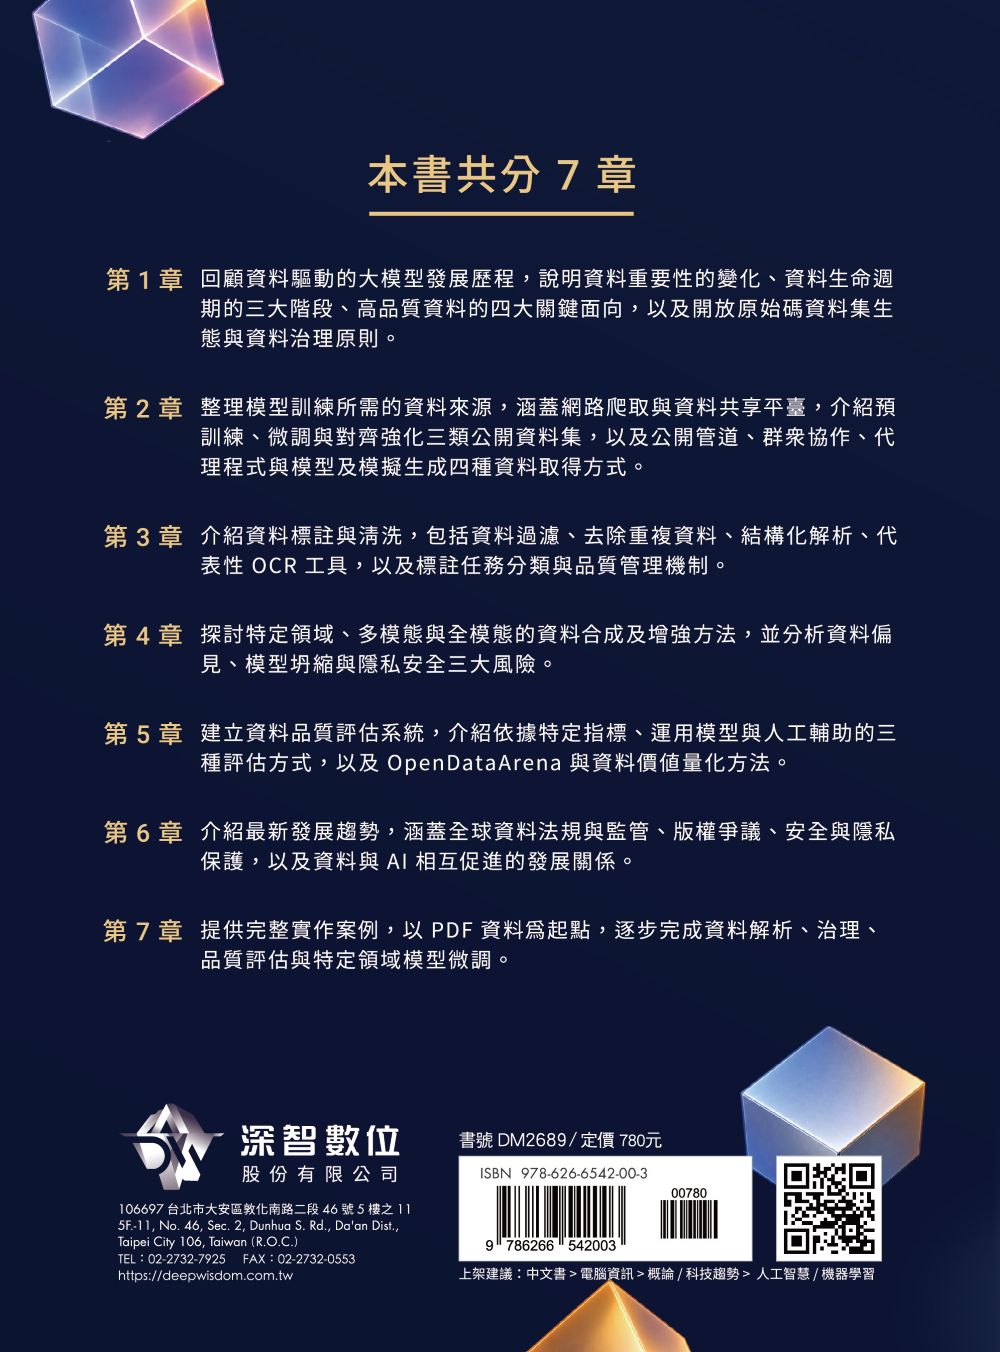
本書共分7章 ◼第 1 章回顧資料驅動的大模型發展歷程,說明資料重要性的變化、資料生命週期的三大階段、高品質資料的四大關鍵面向,以及開放原始碼資料集生態與資料治理原則。 ◼第 2 章整理模型訓練所需的資料來源,涵蓋網路爬取與資料共享平臺,介紹預訓練、微調與對齊強化三類公開資料集,以及公開管道、群眾協作、代理程式與模型及模擬生成四種資料取得方式。 ◼第 3 章介紹資料標註與清洗,包括資料過濾、去除重複資料、結構化解析、代表性 OCR 工具,以及標註任務分類與品質管理機制。 ◼第 4 章探討特定領域、多模態與全模態的資料合成及增強方法,並分析資料偏見、模型坍縮與隱私安全三大風險。 ◼第 5 章建立資料品質評估系統,介紹依據特定指標、運用模型與人工輔助的三種評估方式,以及 OpenDataArena 與資料價值量化方法。 ◼第 6 章介紹最新發展趨勢,涵蓋全球資料法規與監管、版權爭議、安全與隱私保護,以及資料與 AI 相互促進的發展關係。 ◼第 7 章提供完整實作案例,以 PDF 資料為起點,逐步完成資料解析、治理、品質評估與特定領域模型微調。 |
作者簡介
| 何聰輝
清華大學博士,上海人工智能實驗室青年科學家、大模型資料負責人,商湯科技資深研究總監,入選第五屆「上海科技青年35人引領計劃」。長期投入高效能運算與 AI 資料基礎設施的跨領域研究,致力於建構通用人工智慧所需的資料基礎。 在資訊科學學術會議發表論文逾 200 篇,Google 學術搜尋引用次數超過 1 萬次,曾獲戈登.貝爾獎、ACL 2025 最佳主題論文獎等多項榮譽。 主導研發智慧文件解析引擎 MinerU,推出一年即獲 GitHub 5 萬顆星,呼叫次數超過 10 億次,並獲華為、阿里巴巴、騰訊等上百家企業採用。建立的評測基準 OmniDocBench 獲 Google Gemini 與 OpenAI GPT 官方採用;另建構大模型開放資料平臺 OpenDataLab,服務全球 30 萬名開發者。 吳酈軍 上海人工智能實驗室青年科學家,上海交通大學、復旦大學、北京中關村學院博士生指導教授,入選上海市高層級青年人才計畫。 長期投入大型語言模型、資料智慧及 AI for Science 等前沿研究,在《Nature》系列期刊及資訊科學領域的國際會議發表超過 90 篇論文。 曾擔任 ICML、NeurIPS、ICLR、ACL 等國際會議的領域主席,並擔任 NeurIPS 2026 E&D Track Chair。 曾獲微軟亞洲研究院「微軟學者獎學金」,並以核心團隊成員身分,於 WMT 2019 全球機器翻譯競賽中獲得 8 項冠軍,以及 ACL 2024 Language+Molecule 雙賽道冠軍與亞軍。 所開發的模型與資料集累計下載次數超過 40 萬次,提出的演算法廣泛應用於微軟、騰訊、百度、美團等企業的實際業務。 參與研發文件智慧解析引擎 MinerU、多模態大型模型 InternVL,以及多模態科學大型模型 Intern-S。 發起建置 OpenDataArena 平台,為大型模型時代的資料價值評估提供關鍵技術支援,持續推動前沿技術的產業應用。 張文濤 北京大學研究員、博士生指導教授,上海人工智能實驗室研究顧問,北京大學未名青年學者、圖靈班科研指導教授,智源學者。 曾任職於騰訊機器學習平台部、Apple AIML 及加拿大 Mila 人工智慧實驗室。研究領域包括以資料為核心的人工智慧、機器學習系統及 AI for Science。 主持國家自然科學基金重大研究計畫、科技部重點研發計畫(課題)、教育部學科突破先導計畫(Co-PI)。 近 5 年以第一作者或通訊作者身分,在機器學習(ICML、NeurIPS、ICLR)、資料探勘(SIGKDD、WWW)及資料管理(SIGMOD、VLDB、ICDE)等領域發表超過 100 篇 CCF-A 類論文。 截至 2025 年 12 月,Google 學術引用次數超過 1 萬次。曾榮獲 WWW 2022、APWeb 2023、CIKM 2024 最佳論文獎。 主導或參與多套機器學習系統的開源開發。曾獲 Apple Scholar、世界人工智慧大會雲帆獎、ACM SIGMOD 中國新星獎、世界互聯網大會領先科技成果獎、華為火花獎、中國電子學會科技進步一等獎等榮譽 |
目錄
| ▍第 1 章 大型語言模型資料概覽
1.1 資料驅動的大型語言模型演進簡史 1.1.1 大型語言模型進化路線 1.1.2 資料的重要性變遷 1.2 大型語言模型資料的生命週期 1.2.1 生命週期總覽 1.2.2 生命週期的三大階段 1.3 大型語言模型資料的四大關鍵維度 1.3.1 知識廣度 1.3.2 智慧精度 1.3.3 泛化能力 1.3.4 新知洞察 1.4 大型語言模型資料生態系統簡述 1.4.1 開放原始碼資料集生態 1.4.2 工具與平臺鏈路 1.4.3 資料治理與倫理邊界 ▍第 2 章 大型語言模型訓練所需資料來源 2.1 典型的資料來源 2.1.1 大型語言模型訓練所需核心資料的類型 2.1.2 網路爬取與社群媒體收集 2.1.3 資料共用平臺與協作機制 2.1.4 資料來源挑戰與演變 2.2 典型的公開資料集 2.2.1 預訓練資料集:通用知識建構 2.2.2 微調資料集:任務與領域適配 2.2.3 對齊強化資料集:對齊與價值塑造 2.3 資料取得方式 2.3.1 公共通路擷取 2.3.2 眾包擷取 2.3.3 代理式擷取 2.3.4 模型與模擬生成 ▍第 3 章 資料標註與清洗 3.1 從原始資料到高品質語料 3.2 資料清洗:剔除雜訊與冗餘 3.2.1 資料過濾 3.2.2 資料去重 3.3 資料解析:從原始資訊中恢復結構與語義 3.3.1 結構化、半結構化與非結構化資料解析 3.3.2 代表性 OCR 工具 3.4 資料標註:從任務建模到品質保障 3.4.1 資料標註方式與策略系統 3.4.2 資料標註任務分類與系統 3.4.3 資料標註品質保障機制 3.5 小試牛刀 3.5.1 資料解析 3.5.2 資料清洗 3.5.3 資料重寫與增強 ▍第 4 章 資料合成與增強 4.1 資料合成與增強的整體框架 4.2 資料合成方法 4.2.1 資料合成方法概述 4.2.2 領域資料合成 4.2.3 多模態資料合成 4.2.4 全模態資料合成 4.2.5 代表性資料合成工具 4.3 資料增強技術 4.3.1 傳統資料增強方法 4.3.2 大型語言模型時代的資料增強 4.4 資料合成與增強的挑戰和風險 4.4.1 資料偏見與幻覺 4.4.2 模型坍縮 4.4.3 資料隱私與安全 ▍第 5 章 資料品質評估 5.1 資料品質評估系統 5.1.1 大型語言模型時代資料品質評估的重要性 5.1.2 資料品質的多維框架 5.1.3 資料評估方法的分類 5.2 特定指標導向的評估 5.2.1 資料純淨度與品質評估 5.2.2 資料多樣性評估 5.2.3 資料安全性與偏見評估 5.3 基於模型的評估 5.3.1 基於學習難度的篩選 5.3.2 指令進化與複雜性評估 5.3.3 基於模型偏好的品質排序 5.3.4 模型評估方法對比與選擇 5.4 人工輔助的資料品質評估 5.4.1 人工評估的不可或缺性 5.4.2 人工評估的方法與流程 5.4.3 人工評估在大型語言模型時代的核心角色 5.5 資料價值驗證平臺—— OpenDataArena 5.6 資料價值量化方法 ▍第 6 章 資料前沿趨勢展望 6.1 全球大型語言模型資料合規監管趨勢與挑戰 6.1.1 資料合規監管的背景與現狀 6.1.2 全球資料合規監管的主要趨勢與實踐 6.1.3 資料合規監管面臨的挑戰 6.2 大型語言模型訓練資料的版權爭議與合規方案 6.2.1 資料版權爭議焦點 6.2.2 資料版權典型案例 6.2.3 資料版權合規與技術解決方案 6.3 大型語言模型資料安全與隱私保護 6.3.1 資料脫敏與匿名化技術 6.3.2 資料隱私攻擊與防禦機制 6.3.3 綜合性隱私保護趨勢與實踐 6.4 資料與 AI 的協作發展關係 6.4.1 高品質資料加速垂直領域 AI 應用落地 6.4.2 AI 應用促進資料飛輪反哺 AI 發展 ▍第 7 章 案例實作——基於 PDF 資料的垂直領域模型能力提升 7.1 案例概述 7.1.1 微調垂直領域模型時,資料層面的常見問題 7.1.2 從 PDF 到訓練資料:整體處理想法 7.2 資料解析:從 PDF 中穩定提取結構化內容 7.2.1 解析任務與輸出形式 7.2.2 文件結構解析 7.2.3 基於佈局的內容精修 7.2.4 批次處理排程與解析流程 7.2.5 解析結果與後續資料建構 7.3 資料治理:將解析結果轉化為可訓練樣本 7.3.1 資料對齊 7.3.2 資料合成與增強 7.3.3 資料處理 7.3.4 視覺化管線編排與偵錯 7.4 資料品質評估:判斷自動建構資料是否「真的可用」 7.4.1 基於大型語言模型的品質評估方法 7.4.2 品質評估虛擬程式碼範例 7.5 微調垂直領域模型 7.5.1 微調:LLaMA-Factory 7.5.2 動態訓練:DataFlex |
序
| 前言
本書源起 2022 年年底到 2023 年年初,以 ChatGPT 為代表的大型語言模型從天而降,Midjourney 等文生圖應用緊隨其後,在全世界引發了一場人工智慧的海嘯。這些現象級產品的出現,不僅重塑了人機互動的方式,更讓大型語言模型成為科技領域的絕對焦點。 如果說演算法是大型語言模型的引擎,算力是大型語言模型的底座,那麼資料就是大型語言模型的燃料。回顧過去幾年,從 BERT 到 GPT-3,再到如今兆參數規模的 MoE 模型,如 GPT-5,Gemini 3 Pro 等,我們見證了 Scaling Law(縮放定律)的驚人威力:隨著資料量和參數量的指數級增長,模型湧現出了驚人的指令遵循、邏輯推理和上下文學習能力。 然而,在算力可以透過資本堆疊、演算法架構逐漸趨同(Transformer 及其變體)的今天,高品質資料正日益成為大型語言模型領域最核心的門檻與護城河,行業共識正從「以模型為中心(Model-Centric)」加速向「以資料為中心(Data-Centric)」轉變。 在這個背景下,如何高效率地取得、處理、評估和利用資料,顯得尤為關鍵。但無論是學術界還是工業界,關於大型語言模型資料的知識往往散落在各類文獻、技術部落格或開放原始碼專案的零星文件中,缺乏系統性的整理。 • 面對巨量的原始網頁,如何清洗出高品質的預訓練語料? • 在真實資料不足的情況下,如何利用「資料合成」技術打破天花板? • 當資料量大到無法人工全量檢查時,如何建構科學的「品質評估系統」? • 在資料隱私與版權日益敏感的當下,如何確保合規與安全? 這些問題困擾著無數從業者。筆者團隊在過去的大型語言模型研發與落地實踐中,深切體會到 「Garbage In, Garbage Out」(垃圾進,垃圾出)的痛點。我們意識到,僅依靠傳統的 NLP 資料處理流程已無法滿足大型語言模型時代的需求,我們需要一套全新的、涵蓋「擷取— 清洗— 標註— 合成— 評估—治理」的全生命週期方法論。 基於此,我們將團隊在資料工程領域的長期累積,結合目前最前沿的研究成果(如合成資料、資料品質評估等)總結為本書。我們希望透過拆解資料處理的每一個黑箱,為行業提供一份翔實的「大型語言模型資料工程指南」,推動資料要素價值的最大化釋放。 本書主要內容 本書旨在全方位解析大型語言模型背後的資料科學與工程實踐,全書邏輯嚴密,內容涵蓋了從巨觀生態到微觀技術、再到實戰實踐的完整鏈路。首先,從大型語言模型時代的資料範式轉變切入,介紹了資料全生命週期的建構、增強與回饋階段,並勾勒了包含開放原始碼生態及工具鏈的大型語言模型資料生態系統。然後,深入探討了訓練資料的擷取、清洗與標註等核心工程實踐,詳細闡述了從網路爬取到建構高品質語料的技術細節。接下來,深入解析了資料合成與增強技術,包括數學、程式等垂直領域的合成方法及全模態生成趨勢,同時建立了一套包含純淨度、多樣性及安全性的多維度資料品質評估系統。最後,著眼於未來,探討了全球角度下的資料合規監管與安全隱私保護,並提供了一個基於 PDF 資料的垂直領域模型能力提升實戰案例,幫助讀者從理論走向實踐。 本書適讀對象 本書適合希望深入了解大型語言模型資料要素的各類讀者閱讀。對於大型語言模型領域的初學者和同好,本書有助建立對資料生態的全域認知;對於從事實際開發工作的演算法工程師和資料科學家,書中關於資料清洗、合成及評估的工程細節提供了直接的方法論參考;對於企業技術負責人及研究人員,書中的合規監管分析與前沿趨勢探討將為技術決策提供有力支援;同時,希望透過實戰落地的開發者也能從本書的端對端案例中獲得啟發。 致謝 本書的撰寫離不開許多師友和合作夥伴的支持。衷心感謝電子工業出版社的編輯團隊,特別是鄭柳潔老師,你們專業的建議和嚴謹的態度,讓本書的結構更加完善,內容更加翔實。感謝我們的團隊成員和學生們(牛俊博、張欽彤、錢思怡、董和軍、劉政、劉孟捷、陳鏡舟、宋佳澤、裴啟智、盤卓實、唐梓楠、林泓霖、王曉陽、高鑫、李宇、明陳林、黃鉦皓、馮涯林、趙正陽、余榮毅、強美伊),你們在校準寫作、資料整理、程式驗證和圖表繪製方面付出了巨大的努力。特別是牛俊博、劉政、裴啟智、王曉陽、李宇、強美伊,你們為每一章的整體呈現付出了巨大的努力。同時,感謝在成書過程中為我們提供寶貴建議的行業專家鄂維南院士、林達華教授、付昊桓教授,您們的真知灼見讓我們少走了很多彎路。 最後,感謝這個偉大的 AI 時代,讓我們有機會探索智慧的邊界。由於作者水準有限,書中難免存在疏漏之處,懇請讀者們批評指正。 何聰輝 吳酈軍 張文濤 2026 年 1 月 |